更新紀錄2026.09.25 更新:刪除無出處的「七成取決於知識準備」說法,更正長脈絡研究的論文作者,並補上「沒有萬靈丹」結論的原始研究出處。
導讀
本篇說明企業如何用 RAG 把品牌文件變成 AI 可即時檢索的知識,涵蓋四種架構、與長脈絡的取捨及導入關鍵。核心判斷是:以 Hybrid RAG 起步,把知識品質與權限治理當成主要投資,而非只換更強的模型。
六個帶得走的重點
- 回答立基於真實資料RAG 讓 AI 先從知識庫檢索再生成,流程為載入、切塊、向量化、檢索、生成,答案可追溯。
- Hybrid RAG 是預設語意加關鍵字檢索並重排序,是 2026 年多數正式環境的預設推薦,多數品牌從這裡起步。
- 小知識庫可先不建 RAGAnthropic 指出知識庫小於約 20 萬 token 時,完整脈絡加 prompt caching 可能更快更便宜。
- 情境化檢索降低失敗Contextual Retrieval 在 Anthropic 實驗中讓檢索失敗率降低 49%,搭配重排序可達 67%。
- 權限模型必須一致透過 RAG 取得的內容與 metadata,須遵循與直接存取相同的權限模型,避免向量庫成為資安破口。
- 三種內容團隊應用品牌知識庫維持產出一致、智慧客服提供可追溯回覆、提案研究把過往案例變成可查詢知識。
當品牌想讓 AI「用我們自己的知識」回答(例如依品牌指南寫文案、依產品手冊回客服、依過往案例提案),光靠通用模型並不夠。這時就需要 RAG(檢索增強生成):把品牌的文件、資料與知識變成 AI 能即時檢索、引用的「外部記憶」。本篇以 Anthropic、Microsoft 等官方資料與研究為依據,說明 2026 年 RAG 的架構選擇、與長脈絡的取捨,以及企業把知識資產變 AI 可用的導入要點。
什麼是 RAG?
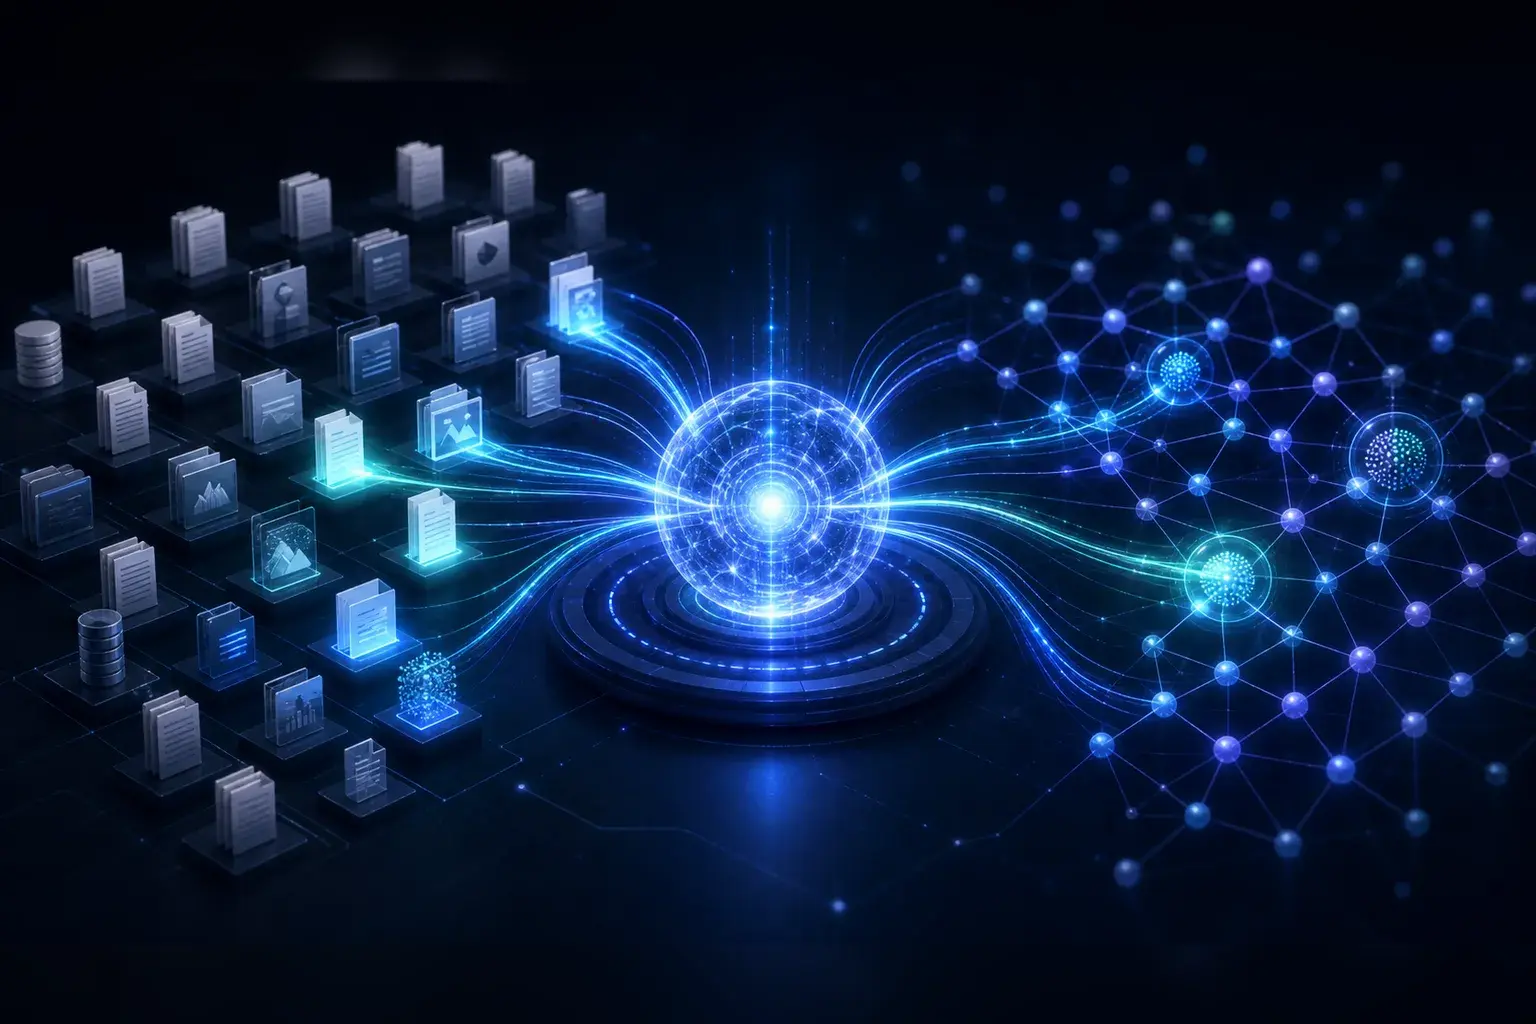
RAG(Retrieval-Augmented Generation,檢索增強生成)是讓 AI 在回答前,先從你的知識庫檢索相關資料,再據此生成答案的技術。核心流程是:載入文件 → 切塊(chunk)→ 向量化(embed)→ 檢索(retrieve)→ 生成(generate)。它的價值在於讓 AI 的回答立基於你的真實資料,而非僅憑模型的訓練記憶,因此能提供即時、可追溯、可控權限的答案。
2026 年的四種 RAG 架構
| 架構 | 做法 | 適用情境 |
|---|---|---|
| Basic RAG | 基本的切塊、向量檢索、生成 | 小型、單一來源知識庫 |
| Hybrid RAG | 語意(dense)+關鍵字(sparse)檢索+重排序 | 2026 預設推薦,多數正式環境 |
| Graph RAG | 用知識圖譜串連實體關係 | 需跨文件推理、關係查詢 |
| Agentic RAG | 把 AI 代理嵌入檢索迴圈,動態規劃並反思 | 複雜、多步驟的查詢任務 |
選擇取決於準確度需求、資料複雜度與預算。多數品牌從 Hybrid RAG 起步即可,複雜關係查詢再考慮 Graph RAG,需要自主多步驟檢索時導入 Agentic RAG。
RAG vs 長脈絡:什麼時候不需要 RAG?
隨著模型脈絡視窗變大,有人問「直接把全部資料塞進 prompt 不就好了?」Anthropic 明確指出:當知識庫小於約 20 萬 token 時,使用完整脈絡加上 prompt caching,可能比建置檢索基礎設施更快也更便宜。但對更大、需要即時更新、權限控管、成本與延遲可控、且可稽核的知識庫,RAG 仍是 2026 年無可取代的方案。
2026 年的最佳實務多為混合:用 RAG 從大型語料做第一階段檢索,再用長脈絡對檢索到的文件做深度推理,結合兩者優勢。研究亦顯示沒有「萬靈丹」:最佳選擇取決於模型規模與長文能力、脈絡長度、任務類型與檢索片段的特性。
提升檢索品質:Contextual Retrieval
RAG 常見的失敗是「檢索到錯誤或不相關的片段」。Anthropic 提出的 Contextual Retrieval(情境化檢索)透過為每個文件片段保留適當的上下文,在其實驗中讓檢索失敗率降低 49%,搭配重排序(reranking)更可降低達 67%。這提醒我們:RAG 的成效,很大程度取決於「知識怎麼準備」,而非用哪個模型。
企業導入 RAG 的三個關鍵
- 知識品質是主要投資:2026 年成功的部署,都把「知識來源的整理與品質」當成核心投資,而非一味追求更強的模型。
- 權限與資料治理:透過 RAG 取得的內容與 metadata,必須遵循與直接存取相同的權限模型,避免向量庫造成資安破口。
- 選對向量資料庫:依規模與架構需求選擇(如 Pinecone 適合大規模企業級、Weaviate 彈性且支援多模態、MongoDB Atlas Vector Search 適合既有 MongoDB 技術棧)。
內容團隊的 RAG 應用情境
- 品牌知識庫:把品牌指南、語氣規範、過往內容變成 AI 可即時引用的依據,維持產出一致性。
- 智慧客服/FAQ:以產品手冊與常見問答為知識源,提供有來源、可追溯的回覆。
- 提案與研究輔助:把過往案例與市場資料變成可查詢知識,加速提案與內容研究。
常見陷阱
- 只換模型不整理知識:知識雜亂時,再強的模型也檢索不到對的答案。
- 忽略權限:把所有資料平鋪進向量庫,可能洩漏不該被存取的內容。
- 過度工程:小知識庫硬建複雜 RAG,不如先用長脈絡+快取。
- 不做評估:缺少檢索品質與答案正確性的評估機制,難以持續改進。
結論
RAG 是把品牌知識資產變成「AI 可用知識」的關鍵橋樑。2026 年的務實做法是:以 Hybrid RAG 起步、把知識品質與權限治理當成核心投資、並依知識庫規模在 RAG 與長脈絡間做取捨。當品牌的指南、資料與經驗都能被 AI 即時、正確、可追溯地引用,內容產出的一致性與效率才能在更多工作中穩定使用。
引用來源
展開 4 則引用來源收合引用來源
- Anthropic, “Introducing Contextual Retrieval.”
- Microsoft Learn, “Retrieval-Augmented Generation (RAG) in Azure AI Search.”
- Yu et al., “In Defense of RAG in the Era of Long-Context Language Models.”
- Li et al., “LaRA: Benchmarking Retrieval-Augmented Generation and Long-Context LLMs.”
FAQ
常見問題
什麼是 RAG(檢索增強生成)?
RAG 是讓 AI 在回答前先從你的知識庫檢索相關資料、再據此生成答案的技術,核心流程為載入文件→切塊→向量化→檢索→生成。它讓 AI 的回答立基於你的真實資料而非僅憑訓練記憶,能提供即時、可追溯、可控權限的答案。
2026 年有哪些 RAG 架構?該怎麼選?
主要有四種:Basic RAG(基本檢索)、Hybrid RAG(語意+關鍵字+重排序,2026 預設推薦)、Graph RAG(知識圖譜跨文件推理)、Agentic RAG(代理嵌入檢索迴圈)。選擇取決於準確度、資料複雜度與預算;多數品牌從 Hybrid RAG 起步即可。
有了長脈絡模型,還需要 RAG 嗎?
視知識庫規模而定。Anthropic 指出當知識庫小於約 20 萬 token 時,完整脈絡加 prompt caching 可能比建檢索設施更快更便宜;但對更大、需即時更新、權限控管、成本延遲可控且可稽核的知識庫,RAG 仍無可取代。2026 最佳實務多為兩者混合。
企業導入 RAG 最重要的關鍵是什麼?
知識品質而非模型。2026 年成功的部署都把知識來源的整理與品質當成核心投資。其次是權限與資料治理(透過 RAG 取得的內容須遵循與直接存取相同的權限模型),以及依規模選對向量資料庫。Anthropic 的 Contextual Retrieval 也顯示妥善準備上下文可將檢索失敗率降低 49%、搭配重排序達 67%。
RAG 的向量資料庫該怎麼選?
文章建議依規模與架構需求選擇:Pinecone 適合大規模企業級應用,Weaviate 彈性且支援多模態,MongoDB Atlas Vector Search 適合已使用 MongoDB 技術棧的團隊。除了資料庫本身,也要確保透過 RAG 取得的內容與 metadata,遵循與直接存取相同的權限模型,避免向量庫造成資安破口。
Contextual Retrieval 是什麼?能改善多少?
RAG 常見的失敗是檢索到錯誤或不相關的片段。Anthropic 提出的 Contextual Retrieval(情境化檢索)會為每個文件片段保留適當的上下文,在其實驗中讓檢索失敗率降低 49%,搭配重排序(reranking)更可降低達 67%,顯示知識怎麼準備對 RAG 成效的影響,往往大於用哪個模型。
導入企業 RAG 知識庫常見哪些陷阱?
文章整理四個陷阱:只換模型不整理知識,知識雜亂時再強的模型也檢索不到對的答案;忽略權限,把所有資料平鋪進向量庫可能洩漏不該被存取的內容;過度工程,小知識庫硬建複雜 RAG 不如先用長脈絡加快取;不做評估,缺少檢索品質與答案正確性的評估機制就難以持續改進。
ABOUT THE AUTHOR
關於作者